Publicidad
GPT-6 Astra Ultrafast: OpenAI acelera hasta 8 veces su IA con GPU Nvidia Blackwell
Revelan cómo sus GPU Blackwell aceleran GPT-6 Astra Ultrafast de OpenAI.
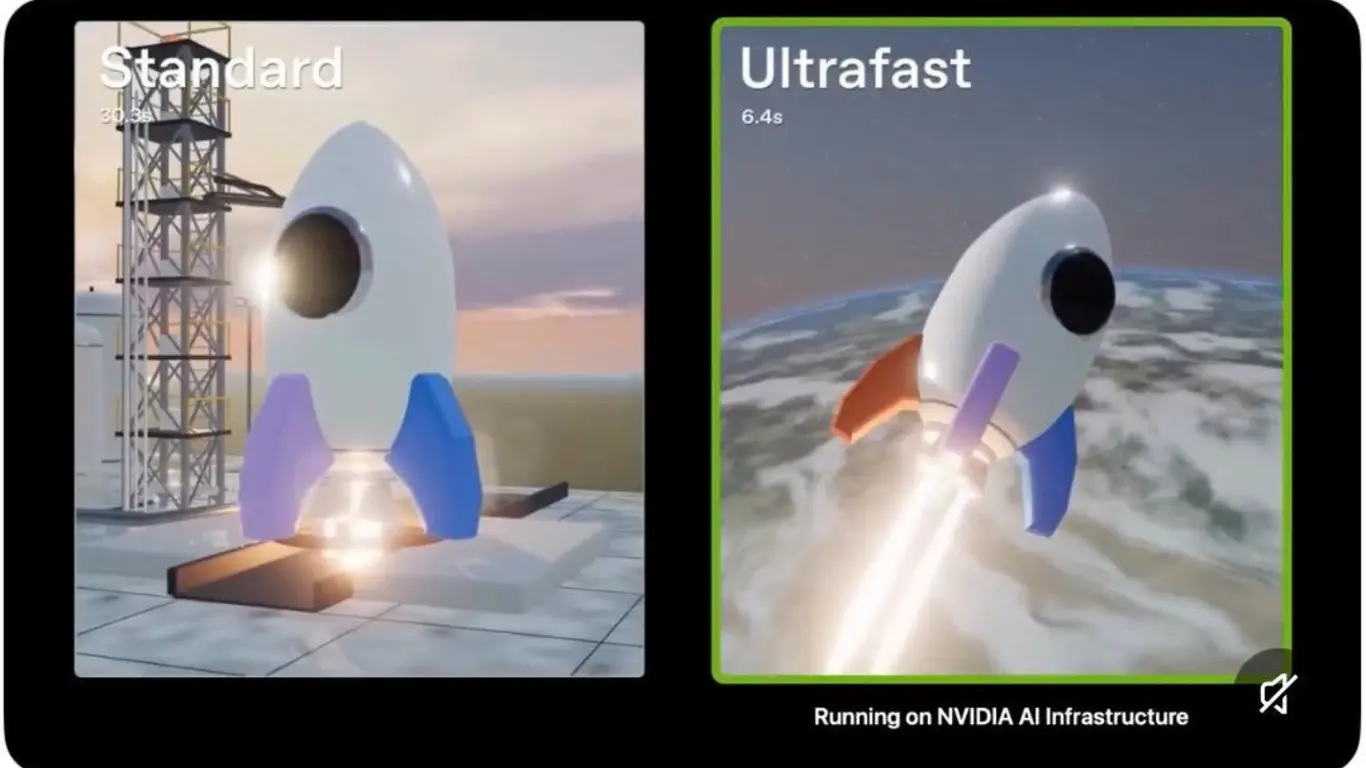
OpenAI y NVIDIA llevaron la velocidad de los modelos de inteligencia artificial a un nuevo nivel con GPT-6 Astra Ultrafast, una modalidad de procesamiento diseñada para reducir la latencia en tareas que requieren respuestas continuas, como programación, agentes de IA, uso de herramientas y aplicaciones interactivas.
La tecnología funciona sobre infraestructura equipada con GPU NVIDIA Blackwell y combina la capacidad de procesamiento del hardware con optimizaciones de inferencia desarrolladas por OpenAI.
Lea también (Agencia Nacional Digital impulsa uso de inteligencia artificial para modernizar entidades públicas)
Según NVIDIA, esta integración permite que Ultrafast alcance una generación de tokens hasta ocho veces más rápida frente al procesamiento estándar de GPT-6 Astra.
La mejora no supone únicamente que una respuesta de texto aparezca más rápido en una pantalla. Su impacto está dirigido especialmente a sistemas de inteligencia artificial que ejecutan cadenas sucesivas de acciones y en los que cada segundo de espera se acumula a lo largo del proceso.
Un agente dedicado a programación, por ejemplo, puede recibir una instrucción, escribir código, utilizar una herramienta, ejecutar una prueba, analizar el resultado, corregir un error y volver a probar el programa.
Cada una de esas etapas puede requerir una nueva inferencia del modelo. Al reducir el tiempo empleado entre esos pasos, la duración total del trabajo también puede disminuir.
OpenAI confirmó que Ultrafast constituye actualmente su nivel de servicio de mayor velocidad para la API. La compañía señala que GPT-6 Astra puede utilizarlo mediante la Responses API y recomienda conexiones persistentes mediante WebSockets especialmente para aplicaciones basadas en agentes que realizan numerosas llamadas a herramientas, debido a que esto permite reducir la sobrecarga generada por establecer nuevas conexiones entre operaciones.
La diferencia resulta importante frente a otras modalidades disponibles. OpenAI mantiene un modo Fast, concebido para ofrecer menor latencia que el procesamiento estándar, pero Ultrafast fue desarrollado como un nivel independiente para las cargas en las que la velocidad constituye un componente central de la aplicación.
NVIDIA explicó que el incremento de rendimiento procede de optimizaciones de inferencia que aprovechan las características de su arquitectura Blackwell.
La inferencia corresponde, en términos generales, al proceso mediante el cual un modelo ya entrenado procesa una entrada y produce una respuesta.
En modelos de lenguaje, uno de los indicadores más visibles de su rendimiento es la velocidad con la que pueden producir los tokens que conforman el resultado.
El trabajo conjunto introduce, además, un elemento que va más allá de disponer de procesadores más rápidos: OpenAI está utilizando sus propios modelos para contribuir a optimizar el software encargado de ejecutar la inferencia sobre las GPU de NVIDIA.
Philippe Tillet, responsable de inferencia de OpenAI, señaló que la inversión de NVIDIA en herramientas y documentación ha permitido que los modelos de la compañía puedan programar de manera eficiente para las arquitecturas Blackwell y Rubin.
“Astra puede convertir ese conocimiento en kernels de alto rendimiento que hacen atractivo el hardware de NVIDIA en toda la frontera de latencia, rendimiento y costo”, explicó Tillet al referirse al trabajo realizado alrededor de Ultrafast, según la información divulgada por NVIDIA.
Los kernels son componentes de software especializados que ejecutan determinadas operaciones directamente sobre los aceleradores. Su optimización puede traducirse en un mejor aprovechamiento de las GPU, mayor cantidad de operaciones procesadas y reducción del tiempo necesario para ejecutar determinados cálculos.
Uday Ruddarraju, director de tecnología de cómputo de OpenAI, indicó que la compañía utilizó modelos internos para optimizar la inferencia ejecutada en las GPU de NVIDIA y destacó la capacidad de programación de esa infraestructura como uno de los factores que hicieron posible la aceleración incorporada en Astra Ultrafast.
Este enfoque permite que las mejoras no necesariamente terminen cuando el modelo entra en producción. OpenAI y NVIDIA pueden continuar modificando y optimizando la capa de software que administra la inferencia, probar cambios y aprovechar nuevas configuraciones del hardware para aumentar progresivamente el rendimiento.
La arquitectura programable también permite emplear una misma infraestructura para diferentes etapas del desarrollo de inteligencia artificial, entre ellas entrenamiento, inferencia y aprendizaje por refuerzo.
Esto facilita redistribuir capacidad computacional según las necesidades de cada carga de trabajo, en lugar de mantener infraestructura especializada sin utilizar durante determinados periodos.
El beneficio resulta especialmente relevante en el desarrollo de agentes autónomos y semiautónomos. A diferencia de una consulta convencional, en la que el usuario formula una pregunta y espera una respuesta, estos sistemas pueden realizar decenas de operaciones para completar una sola tarea.
Pueden consultar información, escribir código, interactuar con aplicaciones, comprobar resultados y decidir posteriormente cuál será la siguiente acción.
GPT-6 Astra, además, dispone de capacidades para uso de computadores, llamadas a herramientas, salidas estructuradas, transmisión de respuestas, orquestación de múltiples agentes, almacenamiento en caché de instrucciones y razonamiento persistente, entre otras funciones documentadas por OpenAI.
En ese escenario, la latencia adquiere un peso diferente. Una reducción aparentemente pequeña en una única interacción puede multiplicarse cuando un agente ejecuta reiteradamente el ciclo de razonar, actuar, recibir información y volver a actuar.
La disponibilidad de Ultrafast también plantea una relación entre velocidad y costo. OpenAI advierte en su documentación que este nivel debe utilizarse principalmente cuando la reducción de latencia justifique un costo superior.
Es decir, no necesariamente está concebido para sustituir el procesamiento estándar en todas las aplicaciones, sino para trabajos en los que la rapidez tenga un valor operativo directo.
OpenAI habilitó GPT-6 Astra Ultrafast para desarrolladores mediante su API. De acuerdo con la documentación vigente, está disponible para usuarios de la API con límites iniciales de procesamiento que varían según el nivel de uso de cada cuenta.
La modalidad también llegó a determinados usuarios de ChatGPT Work y Codex. OpenAI establece condiciones específicas de disponibilidad según el plan y el espacio de trabajo, por lo que el acceso a Ultrafast dentro de esos productos no equivale automáticamente a su disponibilidad general para todos los usuarios de ChatGPT.
Otro aspecto técnico está relacionado con la residencia de los datos. La documentación de OpenAI señala que actualmente Ultrafast admite procesamiento global y residencia de datos en Estados Unidos, pero no los puntos regionales de procesamiento de la Unión Europea ni otras regiones.
El lanzamiento refuerza además la relación tecnológica entre OpenAI y NVIDIA en un momento en el que la competencia alrededor de la inteligencia artificial ya no depende exclusivamente de desarrollar modelos con mayores capacidades.
La infraestructura necesaria para ejecutarlos, el rendimiento de las GPU, la eficiencia del software de inferencia y la reducción de la latencia se han convertido en componentes determinantes para llevar esos modelos a aplicaciones utilizadas de manera continua.
Otras noticias
Etiquetas